人気の偏りを,モデル全体を作り直さずに直す
- 論文名: Efficient Popularity Bias Mitigation in Recommender Systems Based on SISA-Style Partitioned Training
- 著者: Soma Matsuura, Soh Yoshida
どんな研究?
推薦システムには,一部の人気アイテムばかりを勧めてしまう人気バイアスという問題があります.音楽アプリでヒット曲ばかりが流れ,あなたの好みに合うはずのマイナーなアーティストが一向に出てこない,という経験はないでしょうか.これは利用者にとっての推薦の多様性を損なうだけでなく,埋もれたアイテムの作り手にとっても不公平です.
何が問題?
人気バイアスを減らす方法はすでに多く提案されています.しかし,それらはどれも学習データや学習の目的関数を変えるため,偏りの直し方を調整するたびに,モデル全体を一から学習し直す必要があります.数千万人規模のサービスでは,これは時間も電力も莫大にかかります.どう直すかだけでなく,モデルのどこを,どれだけ安く直すかが実用上の課題です.
どう解決?
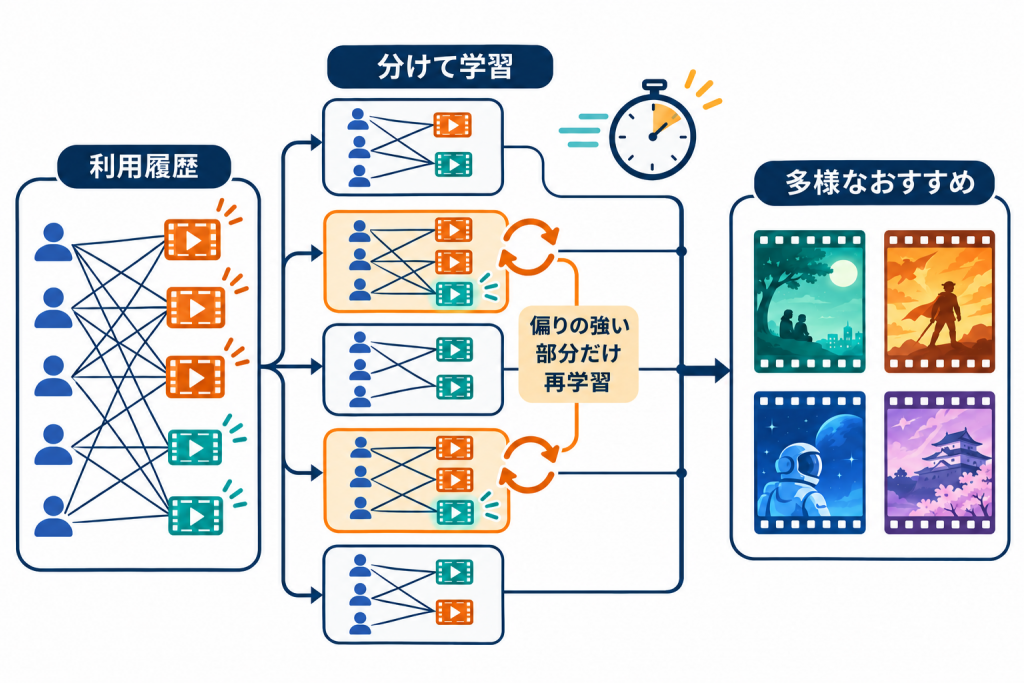
この研究は,まったく別の目的で生まれた機械学習の忘却(machine unlearning)から仕組みを借りてきました.忘却とは,利用者から自分のデータを削除してほしいと言われたときに,そのデータの影響をモデルから取り除く技術です.その代表的手法である SISA(Sharded, Isolated, Sliced, and Aggregated training)は,学習データをいくつかのシャード(断片)に分け,シャードごとに独立した小さなモデルを学習し,推薦時にそれらを合成します.こうしておけば,あるデータの削除はそのデータを含むシャードだけ学習し直せば済みます.図書館の本棚を区画ごとに管理しておけば,一区画だけ整理し直せばよいのと同じ発想です.
ただし SISA はデータを消すために設計されているので,偏りを直すために使うには,分け方と直し方の両方を設計し直す必要があります.この研究では,(1) アイテムの人気度とユーザー間のつながり(グラフ構造)の両方を考慮して,各シャードの人気アイテムの比率を揃える分割法 BPAP(Bias-aware Popularity-balanced Assignment and Partitioning),(2) 各シャードがどれだけ人気アイテムに偏っているかを数値化する指標 BiasScore,(3) 偏りの強いシャードだけを,データを削除せずに,人気アイテムの重みを下げて不人気アイテムを持ち上げる目的関数で学習し直す方法,を提案しました.人気アイテムのデータを消してしまうと,そこに含まれる,誰と誰の好みが似ているかという貴重な情報まで失われてしまうため,消すのではなく重み付けで補正するのがポイントです.
結果
Yelp(飲食店)・MovieLens-1M(映画)・Gowalla(位置情報)の3つのデータで評価しました.提案手法はすべてのデータで人気バイアスを減らし,とくにデータがまばらな Yelp では,比較手法の中で最も高い精度と最も短い総計算時間を同時に達成しました.データを削除する従来方式は偏りを大きく減らせる一方で精度が大きく落ちることが多く,削除ではなく目的関数の補正で直すことの利点が示されました.
キーワード:推薦システム,人気バイアス,グラフニューラルネットワーク,機械学習の忘却,分割学習