文字の美しさを自動採点するとき,その自信のなさも一緒に出す
- 論文名: 手書き中国文字の美的印象評価における深層アンサンブル学習による予測不確実性の分析
- 著者: 松井 智也,吉田 壮
どんな研究?
写真や絵画が見る人に与える美的な印象を,計算機で予測する研究が進められています.その中でも手書き中国文字は,形の美しさが長い歴史の中で培われた書法の原則に根差しているため,文字の形から計算した特徴量をもとに美しさを予測する,というアプローチが有効だと考えられています.文字画像から特徴量を取り出し,そこから印象スコアを出力する回帰問題として定式化し,多層パーセプトロン(Multi-Layer Perceptron, MLP)などの機械学習モデルで予測するのが一般的です.書道教育の支援や,古い木簡のような文化財の解析への応用が期待されています.
何が問題?
美的印象は本質的に主観的で,人によって評価が分かれます.同じ文字を複数人に採点してもらうと,ある文字では全員の評価がそろい,別の文字では大きくばらつきます.つまり,予測したい正解そのものが一つの値として定まらず,評価者の集団の上に分布として存在しています.ところが従来の評価モデルの多くは,一つの点数だけを出力する点推定にとどまっていました.これでは,モデルにとって予測しやすい文字と難しい文字の区別がつかず,出てきた点数をどの程度信じてよいのかが利用者に伝わりません.予測の難しさが文字ごとに大きく異なる美的印象評価では,不確かさを示さない予測は誤った点数を過信させる危険があります.
どう解決?
提案手法は3つの段階からなります.
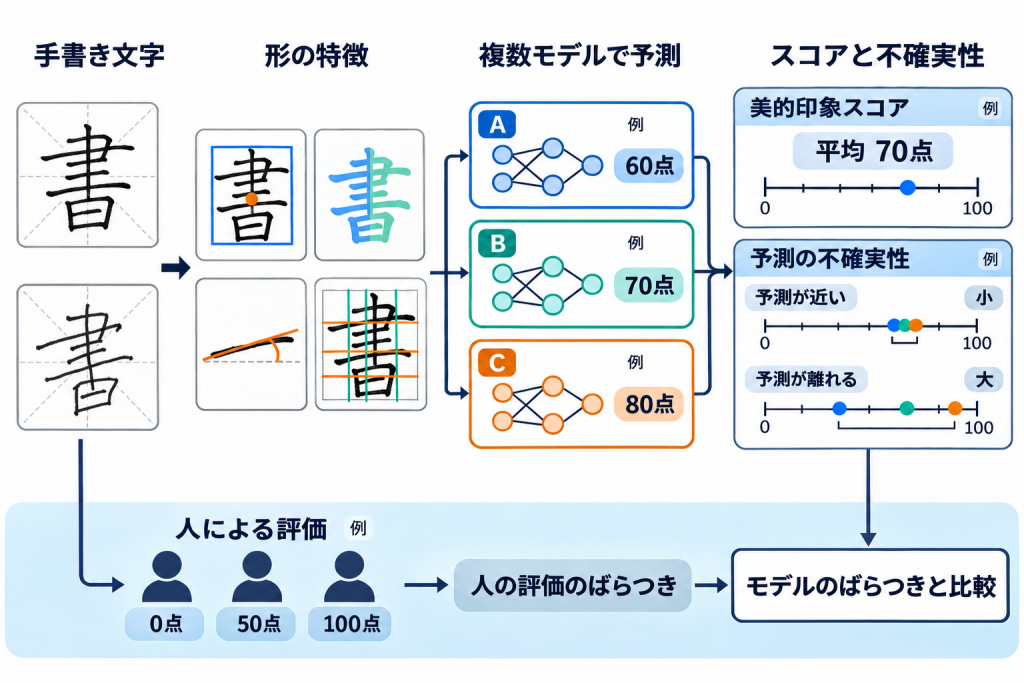
第1段階は特徴量の抽出です.文字画像を白黒の2値画像に変換し,書法の原則に対応する観点から設計された32種類の形状特徴量を計算します.文字の形の安定性(矩形らしさ,文字軸の傾き,重心),余白の分布,字画の密度,そしてアスペクト比や左右対称性などの大域的な特徴,という4つの観点です.
第2段階は構造学習による特徴量の選別です.32種類の特徴量には互いに強く相関するものが多く,すべてをそのまま使うと多重共線性という現象が起きて回帰が不安定になります.そこで,特徴量とスコアの間の統計的な依存関係をベイジアンネットワークという有向グラフとして推定し,グラフ上でスコアに直接つながっている特徴量だけを選びます.すべての特徴量を一度に扱うと相関の強い特徴量同士で不安定な辺が生じやすいため,安定性と対称性,余白の分布と字画の密度,字画の隙間と角度,という書法上の意味に沿ったグループに分けてグループごとに構造を推定します.これにより多重共線性を抑えつつ,どの特徴が点数の根拠になっているかを目に見える形にできます.
第3段階が深層アンサンブル学習です.選別した特徴量を入力とする MLP を,重みの初期値と訓練データを見せる順番を変えて複数個独立に学習させ,全員に同じ文字を採点させます.複数モデルの出力の平均をその文字の予測スコアとし,出力のばらつき(標準偏差)をモデルの予測不確実性とします.モデル同士の意見が割れる文字ほど,予測が難しい文字だとみなすわけです.
結果
手書き中国文字の美的印象評価データベース CHAED(1,000枚の文字画像それぞれに33人の評価者のスコア付き)で評価しました.予測精度を平均絶対誤差(Mean Absolute Error, MAE)で測ると,単一の MLP の13.61に対して深層アンサンブルは13.09となり,精度も改善しました.
不確実性の分析では,33人の採点のばらつきを人間由来の不確実性とし,モデルの予測不確実性と比べました.人間の評価は,誰が見ても整っている文字と誰が見ても乱れている文字ではそろい,中間の文字で割れます.一方,モデルの不確実性は人間のばらつきとは単純には対応しませんでしたが,文字の形を見比べると,構造を崩して字画がつながった行書のような文字で高くなる傾向がありました.崩し字は人間にとってもモデルにとっても評価が定まりにくい文字だといえます.両者は同じ量ではないものの,点推定では得られなかった予測の信頼性に関する補助情報を提供できることを示しました.
キーワード:美的印象評価,手書き文字,深層アンサンブル,予測不確実性