大規模言語モデルに学び方を学ばせ,初めての分野でも数件のデータから推薦する
- 論文名: Meta-LoRA Adaptation for Few-Shot Cross-Domain LLM Recommendation Under Non-Overlapping IDs
- 著者: Kakeru Sugimoto, Soh Yoshida
どんな研究?
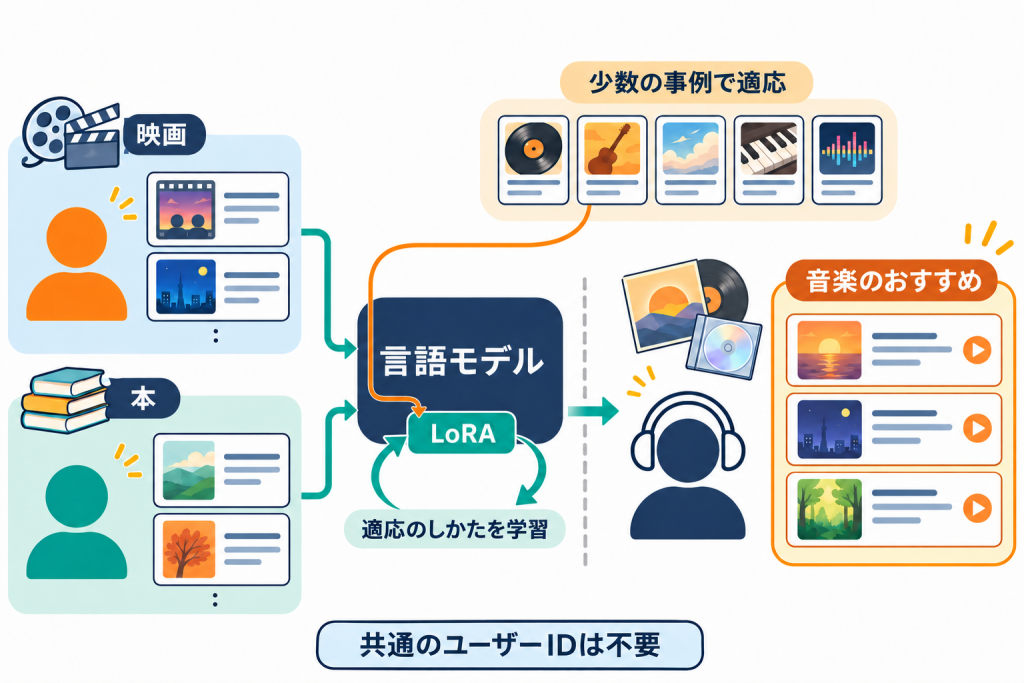
新しく始まったサービスには,まだ利用履歴がほとんどありません.そこで,映画や本など他のサービスの履歴から得た知識を活かして推薦したい,というのがクロスドメイン推薦です.ただし従来の多くの方法は,同じユーザーが両方のサービスを使っていることや,ユーザーIDや商品IDを突き合わせられることを前提にしています.別々の会社のサービス間にそのような対応表は存在しませんし,プライバシーの観点からも共有できません.この研究は,IDが一切共有されていない状況でのクロスドメイン推薦に取り組みました.
どう解決?
鍵になるのは大規模言語モデル(Large Language Model, LLM)です.ユーザーの履歴を,この人はインターステラーとオデッセイを高く評価しました,2001年宇宙の旅を勧めるべきですか,のような文章に変換して LLM に Yes か No を答えさせる方法(TALLRec)があります.商品を ID ではなく文章として扱うので,SF映画が好きな人は宇宙を題材にした小説も好きかもしれない,といった意味のつながりを通じて,ID なしで知識を転用できます.
ただし,映画の履歴と本の履歴を単純に混ぜて学習させると,分野ごとに異なる好みの傾向が干渉してしまいます.そこでこの研究ではメタ学習を導入しました.メタ学習とは学び方そのものを学ぶ手法で,例えるなら,数学・物理・化学をそれぞれ勉強した経験から,新しい科目に短時間で慣れるコツを身につけるようなものです.各ソースドメイン(映画,本)を一つの科目とみなし,どの分野にも数件のデータですばやく適応できる初期状態を学習します.そして推薦時には,学習中に一度も見ていないターゲットドメイン(音楽CD)のデータをわずか5件だけ使って,その初期状態を微調整します.
なお,LLM 全体を学習し直すのは非常にコストが高いため,モデル本体は固定したまま小さな追加パラメータだけを調整する LoRA(Low-Rank Adaptation)という技術を使っています.
結果
MovieLens(映画)と Book-Crossing(本)を学習に使い,Amazon の CD・レコードの購買データを初めて見る分野として評価しました.提案手法は,単純に両分野を混ぜて学習した手法や,LLM に推論過程を生成させる手法(ThinkRec)を上回る精度を達成しました.ターゲットを本や映画に入れ替えた実験でも,データの少ない分野ほど提案手法の優位性が大きいことが確認できました.また,推薦時の5件による微調整が最も精度に効いていることも分かりました.
キーワード:クロスドメイン推薦,大規模言語モデル,LoRA,メタ学習,少数ショット適応