過去のデータに戻れない継続学習で,間違ったラベルの影響をあとから取り除く
- 論文名: 事前学習モデルに基づくクラス継続学習におけるノイジーラベル下での分類器統計量補正
- 著者: 山本 翔平,吉田 壮
どんな研究?
スーパーの商品を画像から自動で認識するシステムを考えてみてください.新商品は次々に発売されるので,システムは新しい商品を順番に覚えていく必要があります.しかも,過去の商品の画像をすべて保存しておくことは,容量やプライバシーの面で難しい場合がほとんどです.このように,新しいクラス(種類)を順番に学びながら,以前に学んだクラスも忘れない,という設定をクラス継続学習(Class-Incremental Learning, CIL)と呼びます.ニューラルネットワークを単純に更新し続けると,以前の知識が失われる破滅的忘却という現象が起こるため,これをどう防ぐかが研究の中心です.
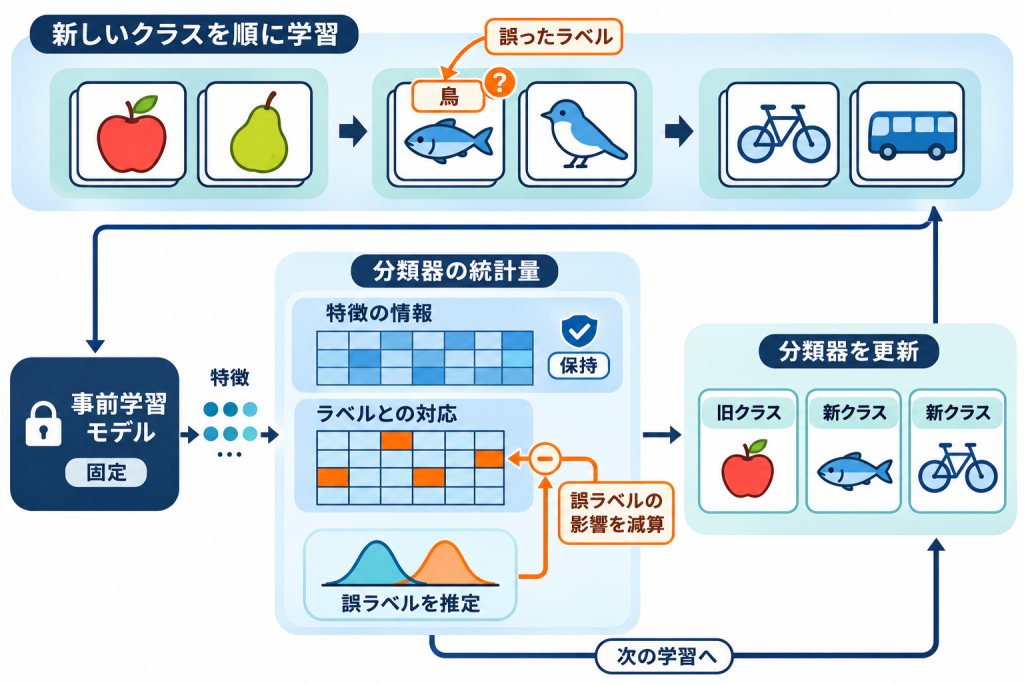
近年は,大規模なデータであらかじめ学習された事前学習モデル(Pre-Trained Model, PTM)を特徴抽出器として固定し,その上に載せる分類器だけを更新する方法が有力です.本研究が土台とする RanPAC(Random Projections and Pre-trained models for Continual learning)はその代表例で,画像の特徴と正解ラベルの対応関係を帳簿のような統計量に足し込んでいき,その帳簿から分類器を計算します.新しいクラスが来たら帳簿に追記するだけなので,過去の画像を保存しておく必要がありません.
何が問題?
現実の学習データには,人のミスや自動収集の誤りによって間違ったラベル(ノイジーラベル)が混ざっています.猫の写真に犬というラベルが付いているような状況です.RanPAC はラベルが正しいことを前提に帳簿へ足し込むため,間違ったラベルの対応関係もそのまま蓄積されます.通常の学習であれば,全データを見直して学習し直せますが,クラス継続学習では過去のデータがもう手元にないので,一度帳簿に書き込まれた誤りをあとから直すのは困難です.
どう解決?
発想はシンプルで,各タスクの学習が終わった直後に,怪しいサンプルを見つけて,その分だけ帳簿から引き算する,というものです.具体的には,学習したばかりの分類器で各訓練サンプルの損失(モデルの予測と与えられたラベルのずれ)を計算します.ラベルが正しいサンプルは損失が小さく,間違ったラベルのサンプルは損失が大きくなる傾向があるので,損失の分布に2成分の混合ガウスモデル(Gaussian Mixture Model, GMM)を当てはめ,損失の大きい側に属するサンプルをノイジーと推定します.そして,それらのサンプルが帳簿に加えた特徴とラベルの対応成分だけを差し引き,分類器を計算し直します.
ポイントは,サンプルそのものを捨てるのではなく,ラベルとの誤った対応だけを取り除くことです.RanPAC は特徴同士の関係を表す統計量と,特徴とラベルの対応を表す統計量を別々に持っているので,前者は残したまま後者だけを補正できます.画像から得られる情報は活かしつつ,間違ったラベルの影響だけを消す,という操作が帳簿の引き算一つで実現できます.
結果
画像分類のベンチマークである CIFAR-100 を10クラスずつ10回に分けて順番に学習させ,ランダムに付け替える対称ノイズ,似たクラスへ付け替える非対称ノイズ,画像の内容に応じて間違えやすいクラスへ付け替える特徴依存ノイズ(Instance-dependent Noise, IDN)の3種類のラベルノイズを加えて評価しました.
ノイズが少ない条件では,正しいサンプルまで引き算してしまうため元の RanPAC のほうが高精度でした.一方,ノイズ率が高い条件,とくに人の間違え方に近い特徴依存ノイズでは,提案手法が明確に精度を改善しました.今後の課題は,ノイジーサンプルの推定精度を高め,低ノイズ条件での引き算のしすぎを抑えることです.
キーワード:継続学習,事前学習モデル,ノイジーラベル,機械学習の忘却